【AI人材検索×C#③】RAGで候補を読み、該当者と理由を返す ~候補の集め方とプロンプト設計~【C#実践アプリ開発ラボ】
キーワード検索とベクトル検索を組み合わせて候補を集め、AIが依頼に合う人とその理由を返す仕組みを、C#でつくります。
キーワード検索とベクトル検索には、それぞれ得意・不得意がありました。どちらか一方では漏れる人も、両方で候補を集めれば拾えるのではないでしょうか。
今回は、両方式で集めた候補をAIに読ませて選ぶRAG(検索拡張生成)を実装します。検索した情報を生成AIへ渡し、その情報を根拠に答えを作る仕組みです。
この記事は、次のような方に役立つ内容になっています。
- 社内の文書や履歴を、自然文で検索できるようにしたい方
- C#の基礎があり、RAGを実コードで動かしてみたい方
- 検索候補から、該当者と理由をセットで返したい方
- RAGにしても必要な候補が漏れる理由を確かめたい方
全3回の連載の最終回です。AI人材検索を題材に、同じ10名の紹介文と同じ4つの依頼で、3つの方式を比べます。
- 第1回:キーワード検索
- 第2回:ベクトル検索
- 第3回:RAG(本記事)
第1・2回では、字面で探す方法と、意味の近さで探す方法を試しました。今回は、その両方を候補収集に使います。各検索の詳しい実装は、第1・2回もあわせてご覧ください。
今回は、2つの検索の得意なところを生かして候補を集め、紹介文を読んだAIに選んでもらいます。候補の集め方が答えにどう影響するかも、確かめていきましょう。
第1〜3回で使用するコードと実測ログの参照先は、GitHubのサンプルリポジトリです。
課題 ── 2つの検索の得意なところを組み合わせたい
第1回(キーワード検索)は紹介文に含まれる語で、第2回(ベクトル検索)は文章の意味の近さで探しました。それぞれの仕組みを振り返りましょう。
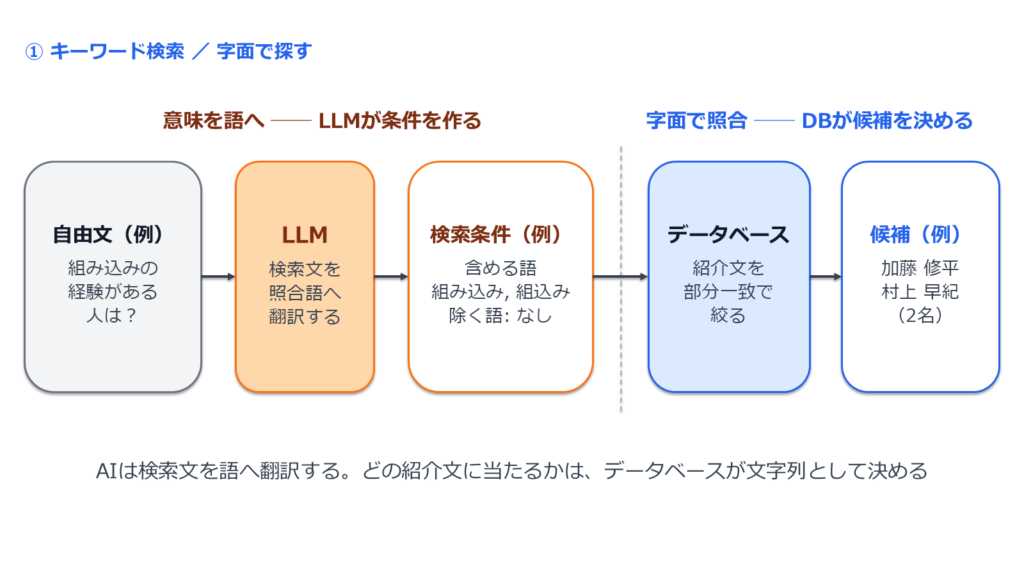
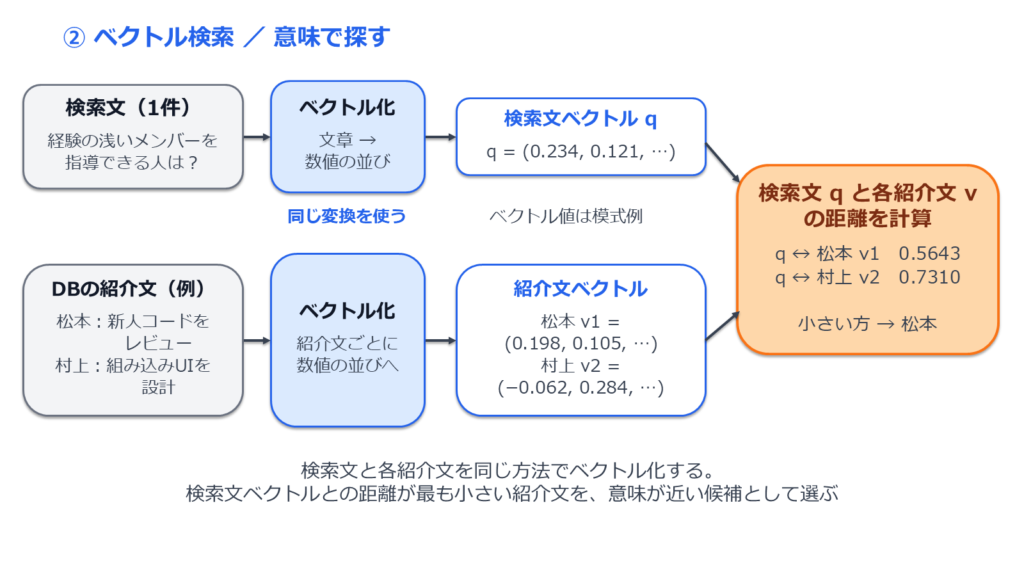
同じ4つの依頼で試すと、どちらの方式にも取りこぼしがありました。結果を比べ、両方の得意なところを組み合わせる方法を考えます。
前回までの結果 ── 取りこぼす依頼が異なる
全3回で使う依頼は次の4つです。正解は、10名の紹介文に書かれた情報を基準に決めています。
| 依頼 | 確かめること |
|---|---|
| A 組み込みの経験がある人は? | 表記ゆれ |
| B Salesforceの導入案件が来た。経験者はいる? | 該当者がいない場合 |
| C 経験の浅いメンバーを指導できる人は? | 依頼と紹介文の語彙のズレ |
| D クラウドの経験がないと思われる人は? | 経験の記載がない人の抽出 |
紹介文の全文は第1回に、元データはData.csにあります。Dでは「実際に未経験か」ではなく、紹介文にクラウド経験の記載がないかを判定します。
| 依頼 | ① キーワード検索(第1回) | ② ベクトル検索(第2回) |
|---|---|---|
| A | ○ 2件 | ○ 2件 |
| B | ○ 0件 | ○ 0件 |
| C | × 0件(松本さんを逃した) | ○ 1件(松本さん) |
| D | ○ 7件 | × 0件 |
A・Bは両方式とも期待どおりでした。違いが出たC・Dについて、何を取りこぼし、もう一方の方式ではなぜ見つかったのかを振り返ります。
依頼C(キーワード検索×、ベクトル検索〇)
C「指導できる人」で探したいのは松本さんです。
紹介文には勉強会や新人のコードレビューの記載がありますが、①が作った「メンター」「育成」などの語はなく、キーワード検索では0件でした。
一方、②のベクトル検索では、その活動と「指導できる人」という依頼の意味が近いため、松本さんが見つかりました。
依頼と紹介文で使う語が違う場合に、ベクトル検索による意味の近さが役立っています。
依頼D(キーワード検索〇、ベクトル検索×)
D「クラウドの経験がないと思われる人」で探したいのは、経験の記載がない7名です。
②ではクラウド経験のある人が上位に並び、距離を境界値で区切った結果も0件でした。
一方、①のキーワード検索では、「クラウド」「Azure」などの語を含む人を除く条件で、7名が見つかりました。
こちらは、意味の近さよりも、キーワード検索による「経験を示す語の有無」の判断が役立っていますね。
今回の課題 ── 両方式の得意なところを生かしたい
この結果では、どちらか一方を使うだけでは、4つの依頼をカバーできません。
依頼ごとに検索方式を選び分ける代わりに、両方の得意なところを組み合わせられないのかな?
今回、その組み合わせを行います!目指すのは、片方で漏れる人も候補に含め、その中から依頼に合う人を選ぶ仕組みです。
候補を広く集めることと、集まった人が条件に合うかを判断することの両方が必要になります。今回は、この2段階をつなぎ、最終的な該当者と選んだ理由を返せるようにします。
解決アプローチ ── 集めた候補をAIに読ませて選ぶ
まずキーワード検索とベクトル検索で候補を集め、重複を除いて合わせます。次に、その候補の紹介文と依頼を生成AIへ渡し、該当者と理由を答えてもらいます。
本連載で比べる3つの方式 ── 字面で探す・意味で探す・読んで選ぶ
図1は、依頼との照合に何を使うかで整理したものです。①は文字列の一致、②は意味の近さ、③はAIによる紹介文の読解を使います。
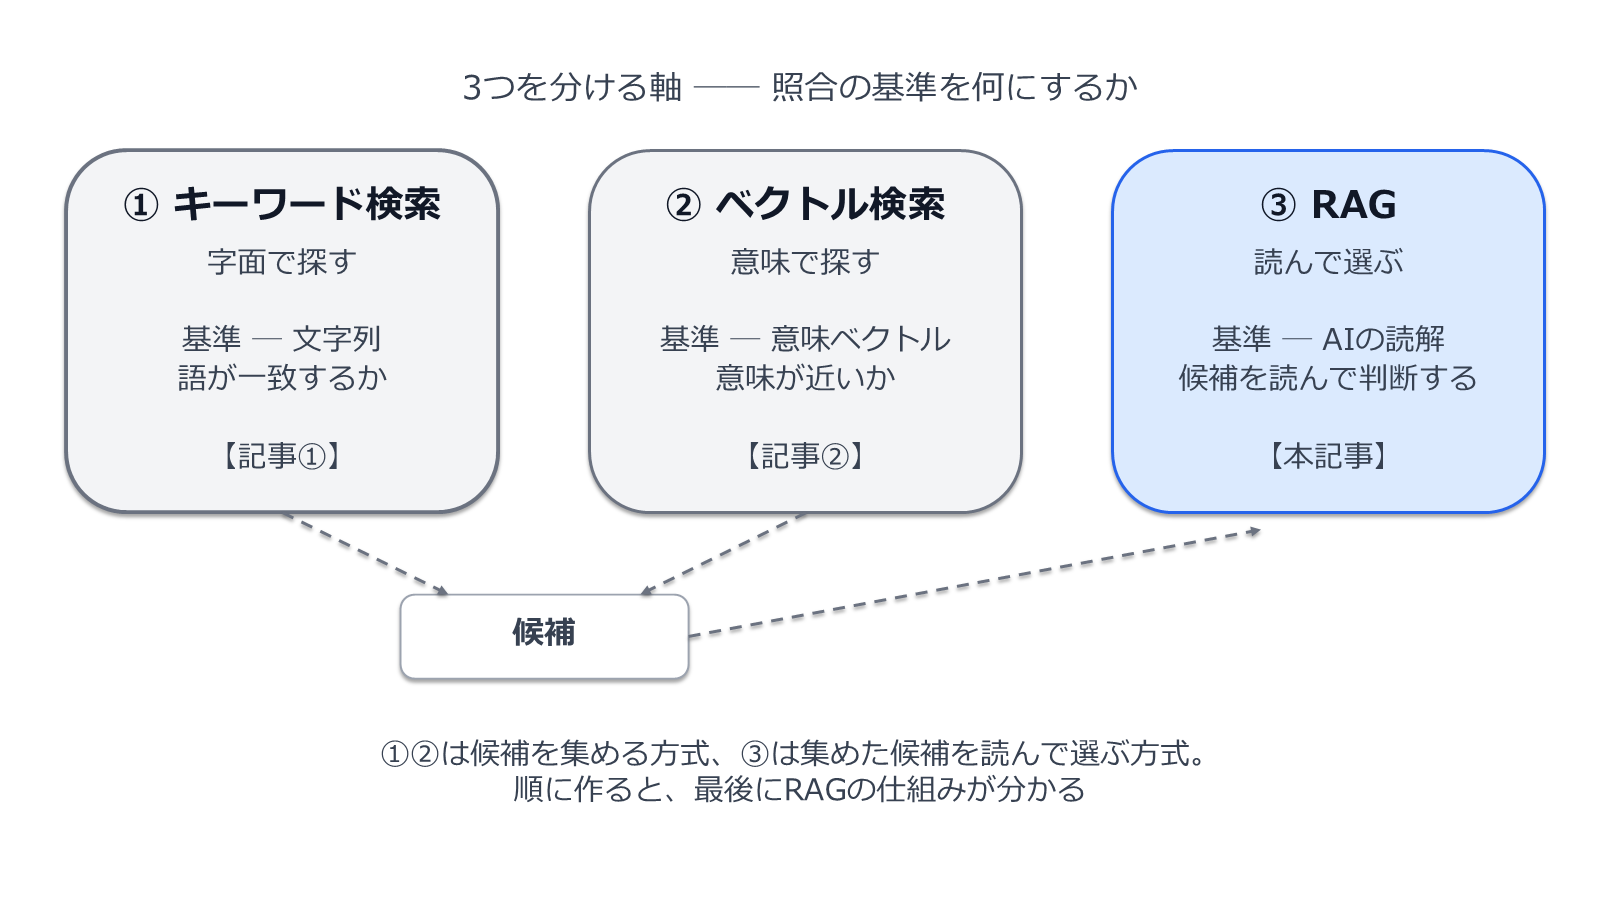
今回の「③RAG」では、「①キーワード検索」・「②ベクトル検索」で集めた候補について、AIがそれぞれの紹介文を読むことで判断します。
方式③ RAG ── 候補の紹介文から、該当者と理由を答える
RAG(参考)は、取得した情報をLLM(文章を理解・生成するAIモデル)へ渡し、回答の根拠にする構成です。
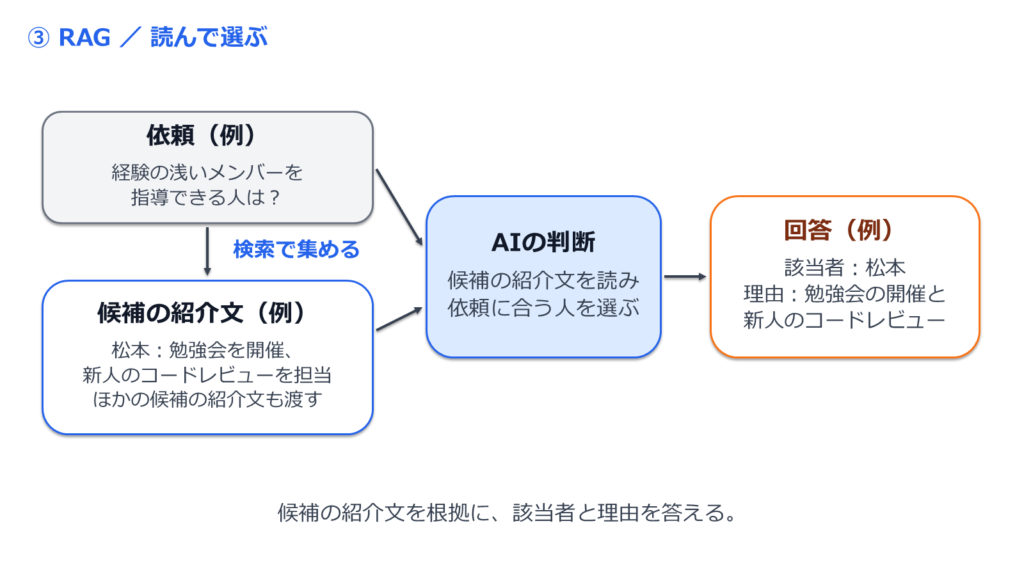
今回の③では、①と②の検索結果の和集合を候補にします。どちらかの検索に出た人を集め、両方に出た同じ人は1名として扱う、という意味です。
この組み合わせは、本連載が採用した候補の集め方です。RAGの検索部分には、キーワード検索だけを使うなど、別の構成も選べます。
本記事で取得するのは、人ごとの紹介文です。AIには、依頼に合う人と、その紹介文のどこを根拠に選んだかを答えてもらいます。
この方法なら、DBに10,000人の社員が登録されていたとしても、可能性の高い候補を先に抽出して、それだけをAIが判定するってことだね!
そうですね。10,000人もいると、検索のたびにAIが全ての紹介文をみて判定するというのは、あまり現実的ではないですね。
候補を絞れば読む量を減らせますが、その段階で必要な人を落とす可能性もあります。候補収集とAIの判断を分けて確認できることが、今回の設計のポイントです。
実装 ── 方式③を、C#で組み立てる
ここからは図3の3つの処理を、C#で実装します。候補収集には第1・2回の処理を使います。
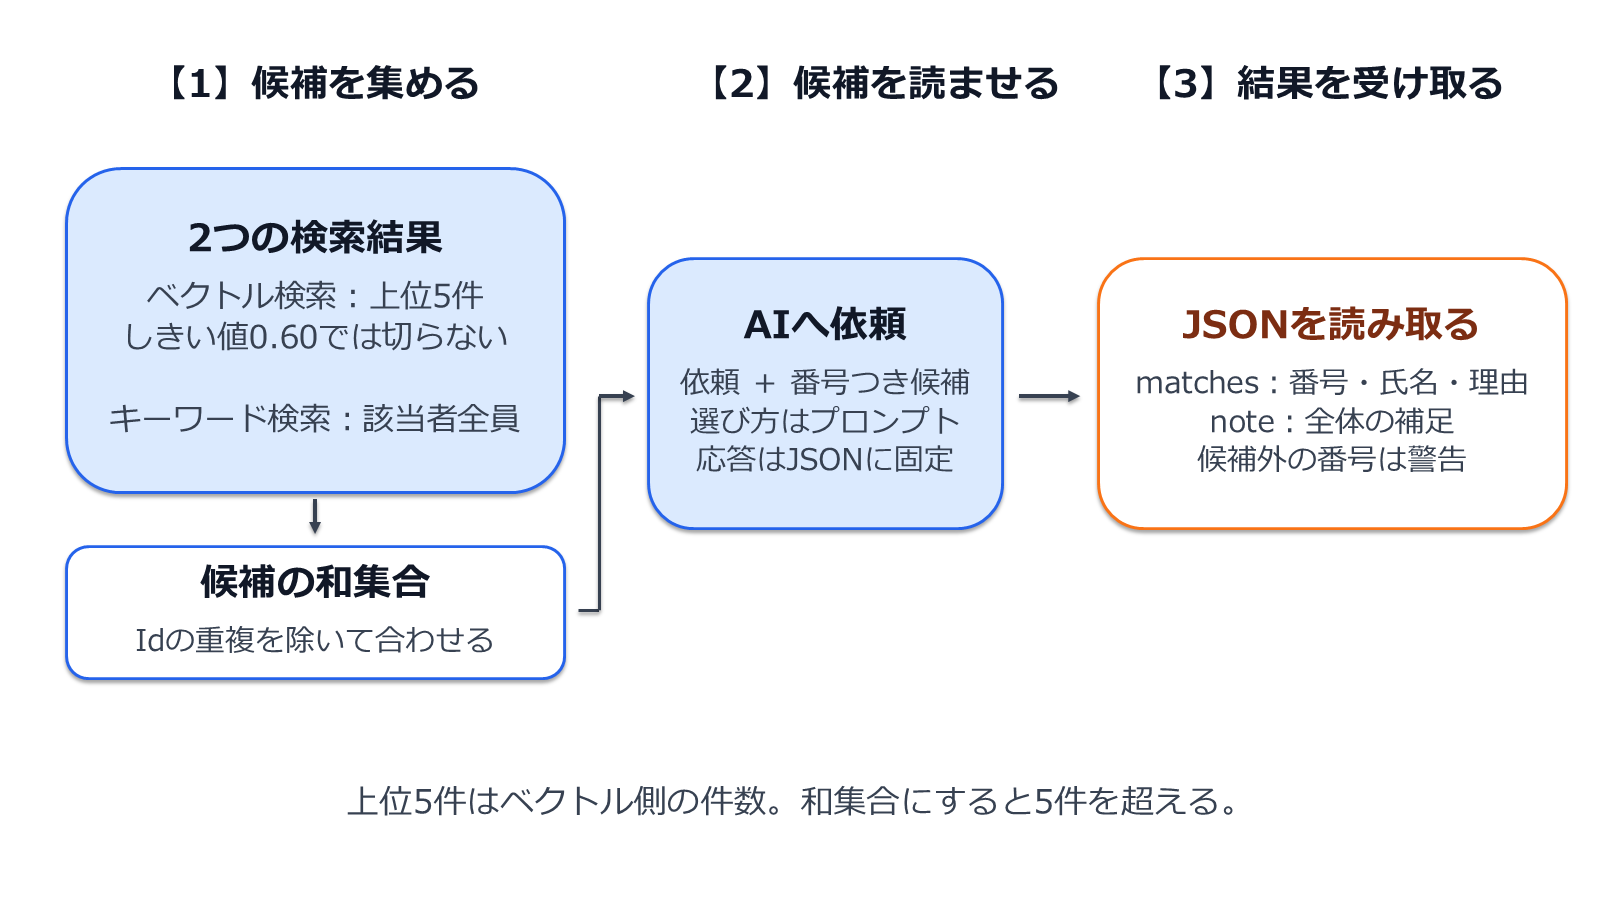
- 【1】候補を集める ── 上位5件とキーワード検索を合わせる
- 【2】候補を読ませる ── 紹介文を根拠に選ばせる
- 【3】結果を受け取る ── 該当者と理由をJSONで扱う
サンプルは.NET 10、EF Core 10.0.10、SQL Server 2025、Azure.AI.OpenAI 2.1.0を使います。
今回の中心はRagJudge.csとprompts/rag.txtです。Azure OpenAIのクライアント接続はSearchEnv.csが担当します。
DBやモデルの準備はREADMEにまとめています。初回のseedは第1・2回と共通です。準備後、20260902_HrSearchフォルダで次を実行します。
dotnet run --project src/HrMatchingSearch -- rag-hybrid "クラウドの経験がないと思われる人は?"RagJudgeクラスから、3つの処理の要点を示すコードを抜粋したものをみてみましょう。説明用コメントを付けています。
【1】候補を集める ── 上位5件とキーワード検索を合わせる
同じ依頼でベクトル検索とキーワード検索を行い、結果の和集合を候補にします。どちらかに出た人を集め、両方に出た人は1名として扱います。
static async Task<List<Candidate>> CollectHybridCandidatesAsync(SearchEnv env, string query)
{
    var byVector = await CollectVectorCandidatesAsync(env, query);   // (1) 上位5件
    var byKeyword = await CollectKeywordCandidatesAsync(env, query); // (2) キーワード条件に合う人
    return Union(byVector, byKeyword);                              // (3) 重複を除いて合わせる
}
(1) のベクトル検索では、第2回で使った距離0.60のしきい値で絞らず、上位5件をすべて候補にします。
この後でAIが紹介文を読んで判断するため、候補を広めに取っておく設計です。
(2) のキーワード検索の結果と合わせた候補一覧を、次の処理へ渡します。5件はベクトル側の件数なので、和集合では5件を超えることもあります。
【2】候補を読ませる ── 紹介文を根拠に選ばせる
AIには、「どう選ぶか」という指示と、「今回の依頼・候補の紹介文」を渡します。
共通の指示をシステムメッセージ、検索のたびに変わる依頼と候補をユーザーメッセージに分けます。
public static async Task<Judgement> JudgeCandidatesAsync(
    SearchEnv env,
    string query,
    List<Candidate> candidates)
{
    // (1) 候補の番号・氏名・紹介文を一覧にする
    var roster = string.Join("\n", candidates.Select(c => $"[{c.Id}] {c.Name}: {c.Bio}"));

    // (2) 選び方の指示と、今回の依頼・候補をAIへ渡す
    var completion = await env.Chat.CompleteChatAsync(
        [
            new SystemChatMessage(Prompts.Rag()),
            new UserChatMessage($"依頼: {query}\n\n候補者:\n{roster}"),
        ],
        new ChatCompletionOptions { ResponseFormat = ChatResponseFormat.CreateJsonObjectFormat() });

    // (3) JSONの回答をC#で扱える形に読み取る(次節)
    return ParseJudgement(completion.Value.Content[0].Text.Trim());
}
(1) で候補の一覧を作り、(2) で依頼と一緒に渡します。Prompts.Rag()が読むrag.txtには、選び方の要点を次のように指定しています。
| 選び方の指示 | 目的 |
|---|---|
| 候補の紹介文だけを根拠にする | 書かれていない経験を推測で補わせない |
| 合う人がいなければ、該当者を返さない | 無理に誰かを選ばせない |
| 選んだ理由を、紹介文の該当箇所とともに簡潔に書く | 判断の根拠を確認できるようにする |
| 「ないこと」を探す依頼では、記述が見当たらないことを理由にしてよい | 記載の有無を条件にして選べるようにする |
最後の指示は、依頼D「クラウドの経験がないと思われる人は?」に関係します。
「経験の記載がない」ことを根拠に選ぶのであって、実際に未経験だと断定するわけではありません。
【3】結果を受け取る ── 該当者と理由をJSONで扱う
AIの回答を画面表示や後続の処理で使うため、該当者と理由をJSONという項目ごとのデータ形式で返してもらいます。
例えば、候補番号3の松本さんを選んだ場合、回答は次のような形になります。
{
  "matches": [
    {
      "id": 3,
      "name": "松本 涼",
      "reason": "勉強会を開き、入ったばかりのメンバーのコードレビューを担当しているため。"
    }
  ],
  "note": ""
}matchesは該当者の一覧です。1名ごとに、候補の番号をid、氏名をname、選んだ理由をreasonに入れます。該当者がいなければ、matchesは空配列[]です。
noteは回答全体への短い補足で、不要なら例のように空文字にします。プロンプトでは、この項目構成でJSONを返すよう指示しています。
このJSONを読み取り、C#側では次の型にまとめます。
public record Match(int Id, string Name, string Reason);
public record Judgement(List<Match> Matches, string Note);Matchが該当者1名分、Judgementが回答全体です。
【2】のCreateJsonObjectFormat()でJSONモードを指定し、(3) のParseJudgementで回答をこの型へ読み取ります。これで氏名や理由を文章から探し出す必要がなくなります。
候補のIdもそのまま返してもらい、元の候補と照合します。サンプルでは、候補にない番号や氏名の食い違いがあれば警告を表示します。
読み取りや表示の詳細はRagJudge.csにあります。
AIの回答は必ず正しいとは限りません。実用上は、返ってきた該当者や理由について、元の紹介文と照らし合わせて確認するとよいでしょう。
ここまでで、候補を集める→紹介文を読ませる→該当者と理由を受け取る処理がつながりました。次は、同じ4つの依頼で結果を確かめます。
実験結果 ── 方式③に、4つの依頼を投げる
完成版のrag-hybridで4つの依頼を各3回実行した結果です。候補数・選んだ人数・氏名は、各依頼で3回とも一致しました。
以下の出力は、すべて各依頼の1回目から抜粋しています。チャットモデルはgpt-5.6-luna、埋め込みモデルはtext-embedding-3-smallです。(参考:実測ログ)
| 依頼 | 渡した候補数 (方式①+②で選出) | 選んだ人数 (AIが判定して選出) | 判定 |
|---|---|---|---|
| A 組み込み | 5名 | 2名 | ○ 加藤さん・村上さん |
| C 指導できる人 | 5名 | 1名 | ○ 松本さん |
| B Salesforce | 5名 | 0名 | ○ 該当者なし |
| D クラウド未経験 | 10名 | 7名 | ○ 経験の記載がない7名 |
表の○は、このサンプルの紹介文に基づく期待結果との一致です。結果としては、方式③RAGによってA~Dのすべてで正解することができました。
それでは、A・C・B・Dの順で結果について詳しくみていきましょう。
A 組み込み ── 2名を、紹介文の根拠とともに返す
期待する答えは、送り仮名の異なる「組込み」「組み込み」が紹介文にある加藤さんと村上さんです。候補5名から、この2名を選びました。
AIに渡す候補: 5件

--- AIの判断: 2名 ---
・ 加藤 修平
    「組込みエンジニア」とあり、C/C++での車載ソフトウェア開発を専門としている。
・ 村上 早紀
    「組み込み機器のユーザーインターフェース設計」の経験がある。
①②と同じ2名に加え、車載ソフトウェア開発や機器の画面設計という、選んだ根拠が返っています。紹介文を開き直すときも、どの記述を確かめればよいかが分かります。
C 指導できる人 ── 勉強会とコードレビューを根拠に選ぶ
期待する答えは松本さんです。キーワード側は0件でしたが、ベクトル側が松本さんを候補に含めていたため、AIに紹介文が届きました。
AIに渡す候補: 5件

--- AIの判断: 1名 ---
・ 松本 涼
    「社内の勉強会を毎週開いていて、入ったばかりのメンバーのコードレビューを引き受けることが多い」ため。
「指導」の語がなくても、勉強会と入ったばかりのメンバーのコードレビューを根拠に選んでいます。
②では距離として表していた依頼とのつながりを、③では文章で確かめられます。
B Salesforce ── 候補5名を読んで、該当者なし
サンプル10名の紹介文にはSalesforce経験の記載がないため、期待する答えは0名です。今回AIに渡した候補は、佐藤さん・岡田さん・鈴木さん・伊藤さん・加藤さんの5名です。
AIに渡す候補: 5件

--- AIの判断: 0名 ---
該当者なし

補足: 候補者の紹介文にSalesforceの導入経験に関する記載はありません。
AIは、候補の紹介文に導入経験の記載がないとnoteの自由文に補足しました。
D クラウド未経験 ── 記載がない7名を選ぶ
期待する答えは、クラウドやAzureの経験が書かれた3名を除く7名です。和集合で候補10名(結果的に全員)を渡した結果、7名が選ばれました。
AIに渡す候補: 10件

--- AIの判断: 7名 ---| 氏名 | AIが返した理由(1回目) |
|---|---|
| 中村 亮 | 「脆弱性診断とペネトレーションテストを担当」とあり、クラウド経験の記載がありません。 |
| 井上 拓海 | 「オンプレのサーバー運用が長い」とあり、クラウド経験の記載がありません。 |
| 鈴木 美咲 | 「フロントエンドエンジニア」とあり、クラウド経験の記載がありません。 |
| 松本 涼 | 「バックエンド担当」とあり、クラウド経験の記載がありません。 |
| 高橋 大輔 | 「Pythonによる機械学習モデルの開発」とあり、クラウド経験の記載がありません。 |
| 加藤 修平 | 「C/C++での車載ソフトウェア開発が専門」とあり、クラウド経験の記載がありません。 |
| 村上 早紀 | 「組み込み機器のユーザーインターフェース設計」とあり、クラウド経験の記載がありません。 |
全員について、クラウド経験の「記載がない」ことを理由にしています。(あくまで紹介文の記載情報からの判断です)
今回、4つの依頼すべてうまくいきましたが、この方式は「候補がきちんと選ばれているか」が重要です。
「依頼D」を題材として、試しに候補の集め方だけを変えた結果を見てみましょう。
考察 ── 方式③の答えは、渡した候補に左右される
依頼Dについて、ベクトル検索の上位5名だけを使うrag-vectorと、キーワード検索との和集合を使うrag-hybridを比べます。
チャットモデルと判断用プロンプトは共通で、変えるのは渡す候補だけです。
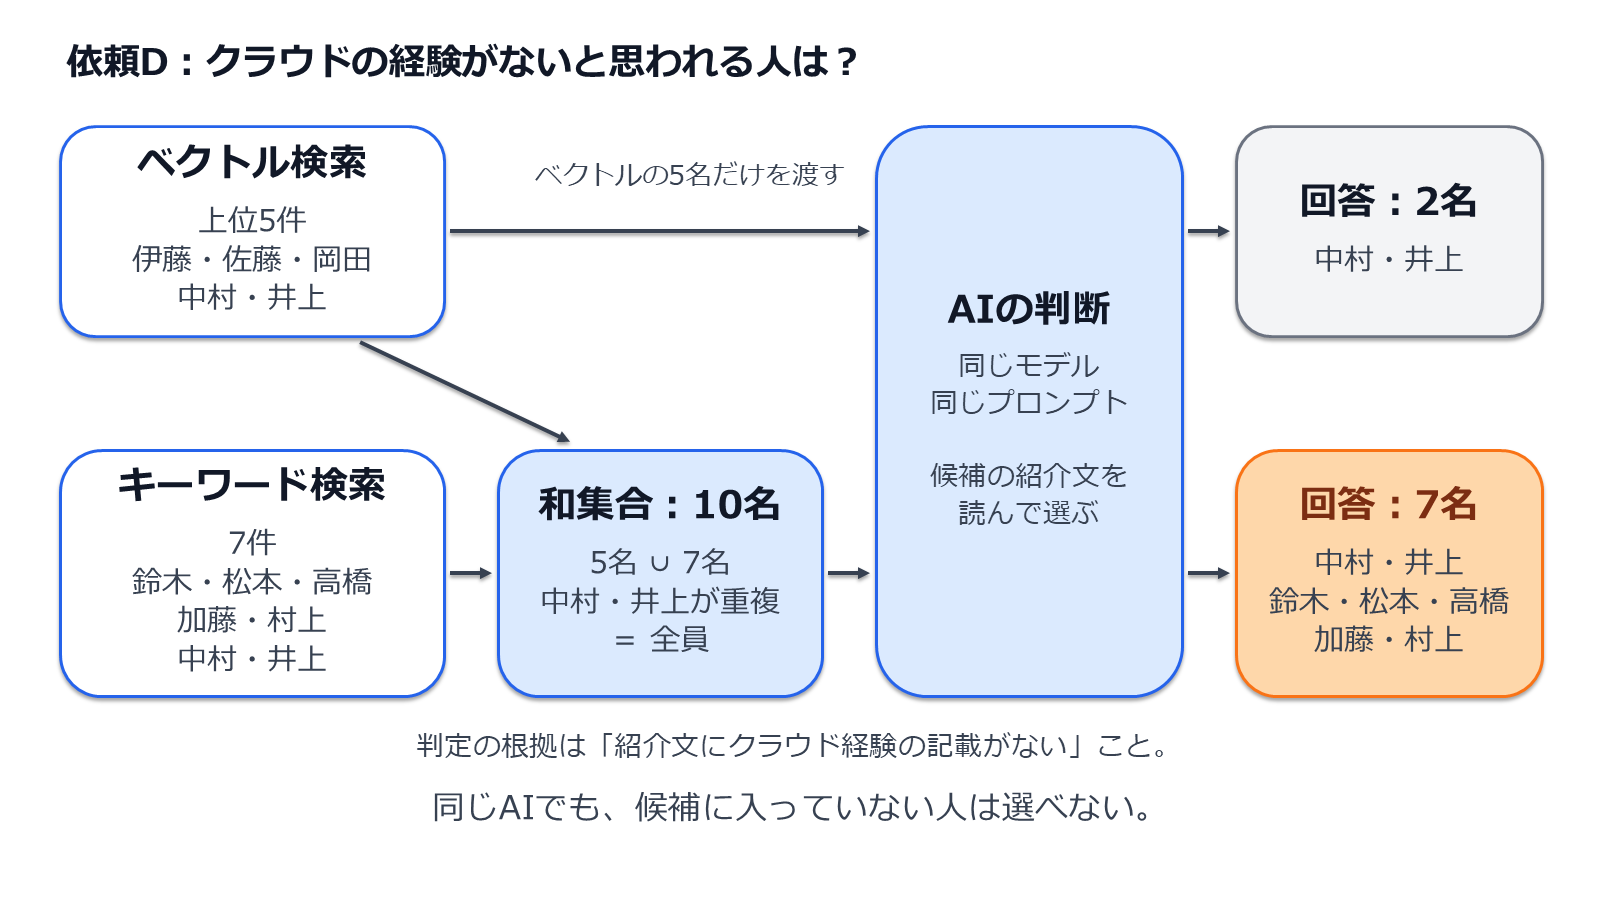
| 候補の作り方 | AIに渡した人数 | 選ばれた人 |
|---|---|---|
| ベクトル検索のみ | 5名 | 中村さん・井上さんの2名 |
| ベクトル検索とキーワード検索の和集合 | 10名 | 中村さん・井上さん・鈴木さん・松本さん・高橋さん・加藤さん・村上さんの7名 |
それぞれ3回とも同じ人数・氏名でした。
AIは、候補に含まれていない人を選べません。今回の差は、必要な人の紹介文がAIに届いていたかどうかで生まれました。
そのため、候補を集める段階では、正解となる人をなるべく漏らさず含めることが大切です。該当しない人が多少混ざっていても、後段のAIに紹介文を読ませて絞り込めます。
今回のように検索方法を組み合わせるのも、そのための工夫です。RAGの回答を改善するときは、AIへの指示とともに、必要な人を候補として集められているかを確認しましょう。
参考:実務のRAGで考えること
本連載では、短い紹介文を検索し、AIが判断する基本構成を扱いました。実務では、対象文書や質問に応じて、次のような工夫も役立ちます。
長い文書は、意味のまとまりで小分けにして、それぞれをベクトル化します。このチャンク分割により、質問に関係する箇所を取り出しやすくなります。
集めた情報だけでは答えられない場合は、検索語や範囲を変えて探し直します。結果を見て、AIが次の検索を組み立てる反復検索という方法もあります。
まとめ
キーワード検索とベクトル検索を組み合わせて候補を集め、RAGで該当者と理由を返す仕組みをつくりました。
今回のサンプルでは、単独の検索で取りこぼした依頼も含め、4つとも期待結果と一致しました。
今回のポイントは以下です。
- 両方式で候補を集め、AIが選ぶ:キーワード検索とベクトル検索の和集合を、紹介文から判断する
- JSONで該当者と理由を扱う:IDで候補と照合し、氏名で検算する
- 候補の漏れと回答の範囲を確認する:候補外の人については判断できない
3つの方式は、依頼とデータに合わせて選び、組み合わせられます。
| 方式 | この実験で生かせた場面 |
|---|---|
| ① キーワード検索:字面で探す | 表記ゆれを語へ展開する/語の有無で条件を作る |
| ② ベクトル検索:意味で探す | 依頼と紹介文の語彙が違う候補を探す |
| ③ RAG:読んで選ぶ | 候補の紹介文から該当者を選び、理由を返す |
まずは手元の小さなデータで、期待する答えが分かる依頼を用意してみてください。候補一覧と最終回答を見比べると、自分の用途でどの方式が役立つかを確かめられます。
全3回で、字面で探す・意味で探す・読んで選ぶ、という3つの仕組みを試しました。ぜひ、ご自身のデータでも動かしてみてください!